
04. Организация параллельной обработки с использованием средств исключения и предупреждения состязаний
Лекция №4. Организация параллельной обработки с использованием средств исключения и предупреждения состязаний
Курс: Системное программирование (2026–2027)
Учебная программа: 2025, регистрационный № УП-46/2025Пп/уч
Специальность переподготовки: 9-09-0612-02 «Программное обеспечение информационных систем»
Квалификация: Инженер-программист
Тема по программе: Тема 4. Организация параллельной обработки с использованием средств исключения и предупреждения состязаний (4 академических часа)
Формируемые компетенции: СП-23, СП-24
Введение и цели занятия
📌 Слайд 1: Тема 4. Организация параллельной обработки с использованием средств исключения и предупреждения состязаний
Современные вычислительные комплексы представляют собой симметричные многопроцессорные системы (SMP, Symmetric Multiprocessing) с десятками и сотнями аппаратных ядер, многоуровневой иерархией кэш-памяти и поддержкой суперскалярного внеочередного исполнения машинных инструкций (Out-of-Order Execution). Организация эффективной параллельной обработки данных требует от системного инженера не только умения запускать параллельные потоки вычислений, но и глубокого понимания физических механизмов взаимодействия процессора с оперативной памятью, природы состояний гонки (Race Condition), аппаратных гарантий атомарности и математических основ взаимного исключения.
На предыдущих лекциях мы изучили жизненный цикл процессов и потоков (Тема 2) и примитивы уровня ядра операционной системы (Тема 3). Однако использование тяжеловесных объектов ядра для защиты каждой элементарной операции в высоконагруженных многопоточных приложениях приводит к неприемлемым накладным расходам из-за постоянного переключения контекста между пользовательским пространством (Ring 3) и пространством ядра (Ring 0).
Цель настоящей лекции — всесторонне изучить теоретические и практические аспекты параллельной обработки данных: от чисто программных алгоритмов взаимного исключения (алгоритм Петерсона) и аппаратных инструкций атомарного сравнения с обменом (CAS, LOCK CMPXCHG) до легковесных блокировок пользовательского режима (SRWLock, CRITICAL_SECTION, futex), классических задач координации («производители-потребители», «обедающие философы») и математического анализа проблемы взаимоблокировок (Deadlock) на основе условий Коффмана.
📌 Слайд 2: План лекции
Учебные вопросы лекции:
- Параллельная обработка данных и разделяемые ресурсы. Состояния гонки и критерии Дейкстры.
- Программные решения задачи взаимного исключения: алгоритм Петерсона и влияние внеочередного исполнения инструкций ЦПУ.
- Аппаратная поддержка атомарности: шинные блокировки, протокол когерентности кэшей MESI, инструкция Compare-And-Swap (CAS) и проблема ABA.
- Иерархия примитивов синхронизации и накладные расходы: атомики, спинлоки,
SRWLock, двухфазные гибридные блокировки (CRITICAL_SECTION,futex). - Условные переменные (Condition Variables) и шаблон безопасного ожидания предиката.
- Классическая задача синхронизации «Производители–Потребители» (Bounded Buffer Problem) и её реализация.
- Проблема взаимоблокировок (Deadlock): 4 условия Коффмана, графы распределения ресурсов и стратегии предотвращения.
- Задача об обедающих философах (Dining Philosophers) как модель ресурсного голодания (Starvation) и дедлока.
1. Параллельная обработка и проблема состязаний
📌 Слайд 3: Параллельная обработка и разделяемые ресурсы
В многопоточном приложении потоки одного процесса разделяют единое виртуальное адресное пространство: общую кучу (Heap), глобальные и статические переменные, дескрипторы открытых файлов и сетевых сокетов. Параллелизм позволяет достичь максимального масштабирования производительности за счет одновременного выполнения вычислений на нескольких физических ядрах ЦПУ.
Однако если доступ к разделяемой памяти не скоординирован и хотя бы один поток выполняет операцию модификации (записи), возникает недетерминированное поведение программы:
- Состояние гонки (Race Condition): ситуация, при которой результат работы программы зависит от относительного порядка и чередования выполнения инструкций различными потоками планировщиком операционной системы.
- Искажение данных (Data Corruption): частичная запись составных структур данных, когда один поток считывает промежуточное, логически несогласованное состояние объекта.
📌 Слайд 4: Проблема состязаний (Race Condition) и условия Дейкстры
Участок кода программы, обращающийся к разделяемому ресурсу, модификация которого должна быть изолирована от других потоков, называется критической секцией (Critical Section).
В 1965 году Эдсгер Дейкстра сформулировал три фундаментальных критерия, которым обязан удовлетворять любой корректный механизм синхронизации критических секций:
- Взаимное исключение (Mutual Exclusion): ни в какой момент времени в критической секции не может находиться более одного потока одновременно.
- Прогресс (Progress): если ни один поток не находится в критической секции, а несколько потоков желают в нее войти, выбор потока, которому будет разрешен вход, не может откладываться бесконечно (отсутствие дедлока при входе).
- Ограниченное ожидание (Bounded Waiting): для любого потока время ожидания входа в критическую секцию должно быть конечным; система должна гарантировать отсутствие ресурсного голодания (Starvation), когда один поток бесконечно уступает дорогу другим.
2. Программное взаимное исключение: алгоритм Петерсона
📌 Слайд 5: Алгоритм Петерсона для двух потоков
До появления специализированных аппаратных инструкций синхронизации ученые искали математические алгоритмы обеспечения взаимного исключения исключительно за счет обычных операций чтения и записи в память. Наиболее элегантным решением для двух потоков стал алгоритм Петерсона (1981 год).
Алгоритм использует две разделяемые переменные:
bool flag[2]— массив флагов намерения:flag[i] = trueозначает, что поток $i$ хочет войти в критическую секцию;int turn— переменная очереди (вежливости): указывает, чей сейчас ход.
 1// Глобальные разделяемые переменные
 2bool flag[2] = {false, false};
 3int turn = 0;
 4
 5// Код потока 0 (для потока 1 — строго симметрично с заменой индексов 0 <-> 1)
 6void EnterCriticalSection_Peterson(void) {
 7    flag[0] = true; // Заявляем о своем намерении войти
 8    turn = 1;       // Проявляем "вежливость": уступаем ход потоку 1
 9
10    // Активное ожидание: крутимся в цикле, пока поток 1 желает войти И сейчас его ход
11    while (flag[1] && turn == 1) {
12        // Spin wait (пауза ЦПУ)
13    }
14}
15
16void LeaveCriticalSection_Peterson(void) {
17    flag[0] = false; // Снимаем намерение: освобождаем секцию
18}
Доказательство корректности алгоритма:
- Взаимное исключение: чтобы оба потока оказались в критической секции одновременно, необходимо, чтобы условия
flag[1] && turn == 1иflag[0] && turn == 0одновременно оказались ложными приflag[0] == trueиflag[1] == true. Но переменнаяturnатомарно равна либо 0, либо 1, и не может одновременно принимать оба значения. Тот поток, который записалturnпоследним, перезаписал значение и сам себя заблокировал в циклеwhile. - Прогресс и отсутствие голодания: если поток 1 не претендует на вход (
flag[1] == false), поток 0 проходит циклwhileмгновенно.
📌 Слайд 6: Out-of-Order исполнение и барьеры памяти (Memory Fences)
Хотя алгоритм Петерсона математически безупречен на модели последовательной консистентности (Sequential Consistency) фон Неймана, на современных процессорах x86, ARM и RISC-V наивная реализация алгоритма Петерсона категорически не работает!
Причина кроется в архитектуре современного конвейера ЦПУ:
- Буферы записи (Store Buffers): процессор не ждет физической записи данных в кэш L1, а помещает операцию записи в буфер Store Buffer и немедленно продолжает исполнение следующих инструкций чтения. В результате возникает аппаратное переупорядочивание: операция чтения (
Load flag[1]) обгоняет предшествующую операцию записи (Store flag[0] = true) — так называемый феномен Store-Load Reordering. - Оптимизации компилятора: компилятор C/C++ при включенной оптимизации (
-O2,-O3) имеет право переставить инструкции местами или закэшировать переменные в регистрах процессора, если они не объявлены как атомарные.
Для восстановления корректности требуются барьеры памяти (Memory Fences / Barriers):
- Инструкция
MFENCE(в архитектуре x86/x64) принудительно останавливает конвейер до тех пор, пока все предыдущие операции записи из Store Buffer не будут зафиксированы в кэше и не станут видны всем ядрам процессора. - В современном стандарте C11 / C++11 для этого применяются операции с моделью согласованности
std::memory_order_seq_cst.
📌 Слайд 7: Программное взаимное исключение и аппаратные атомики
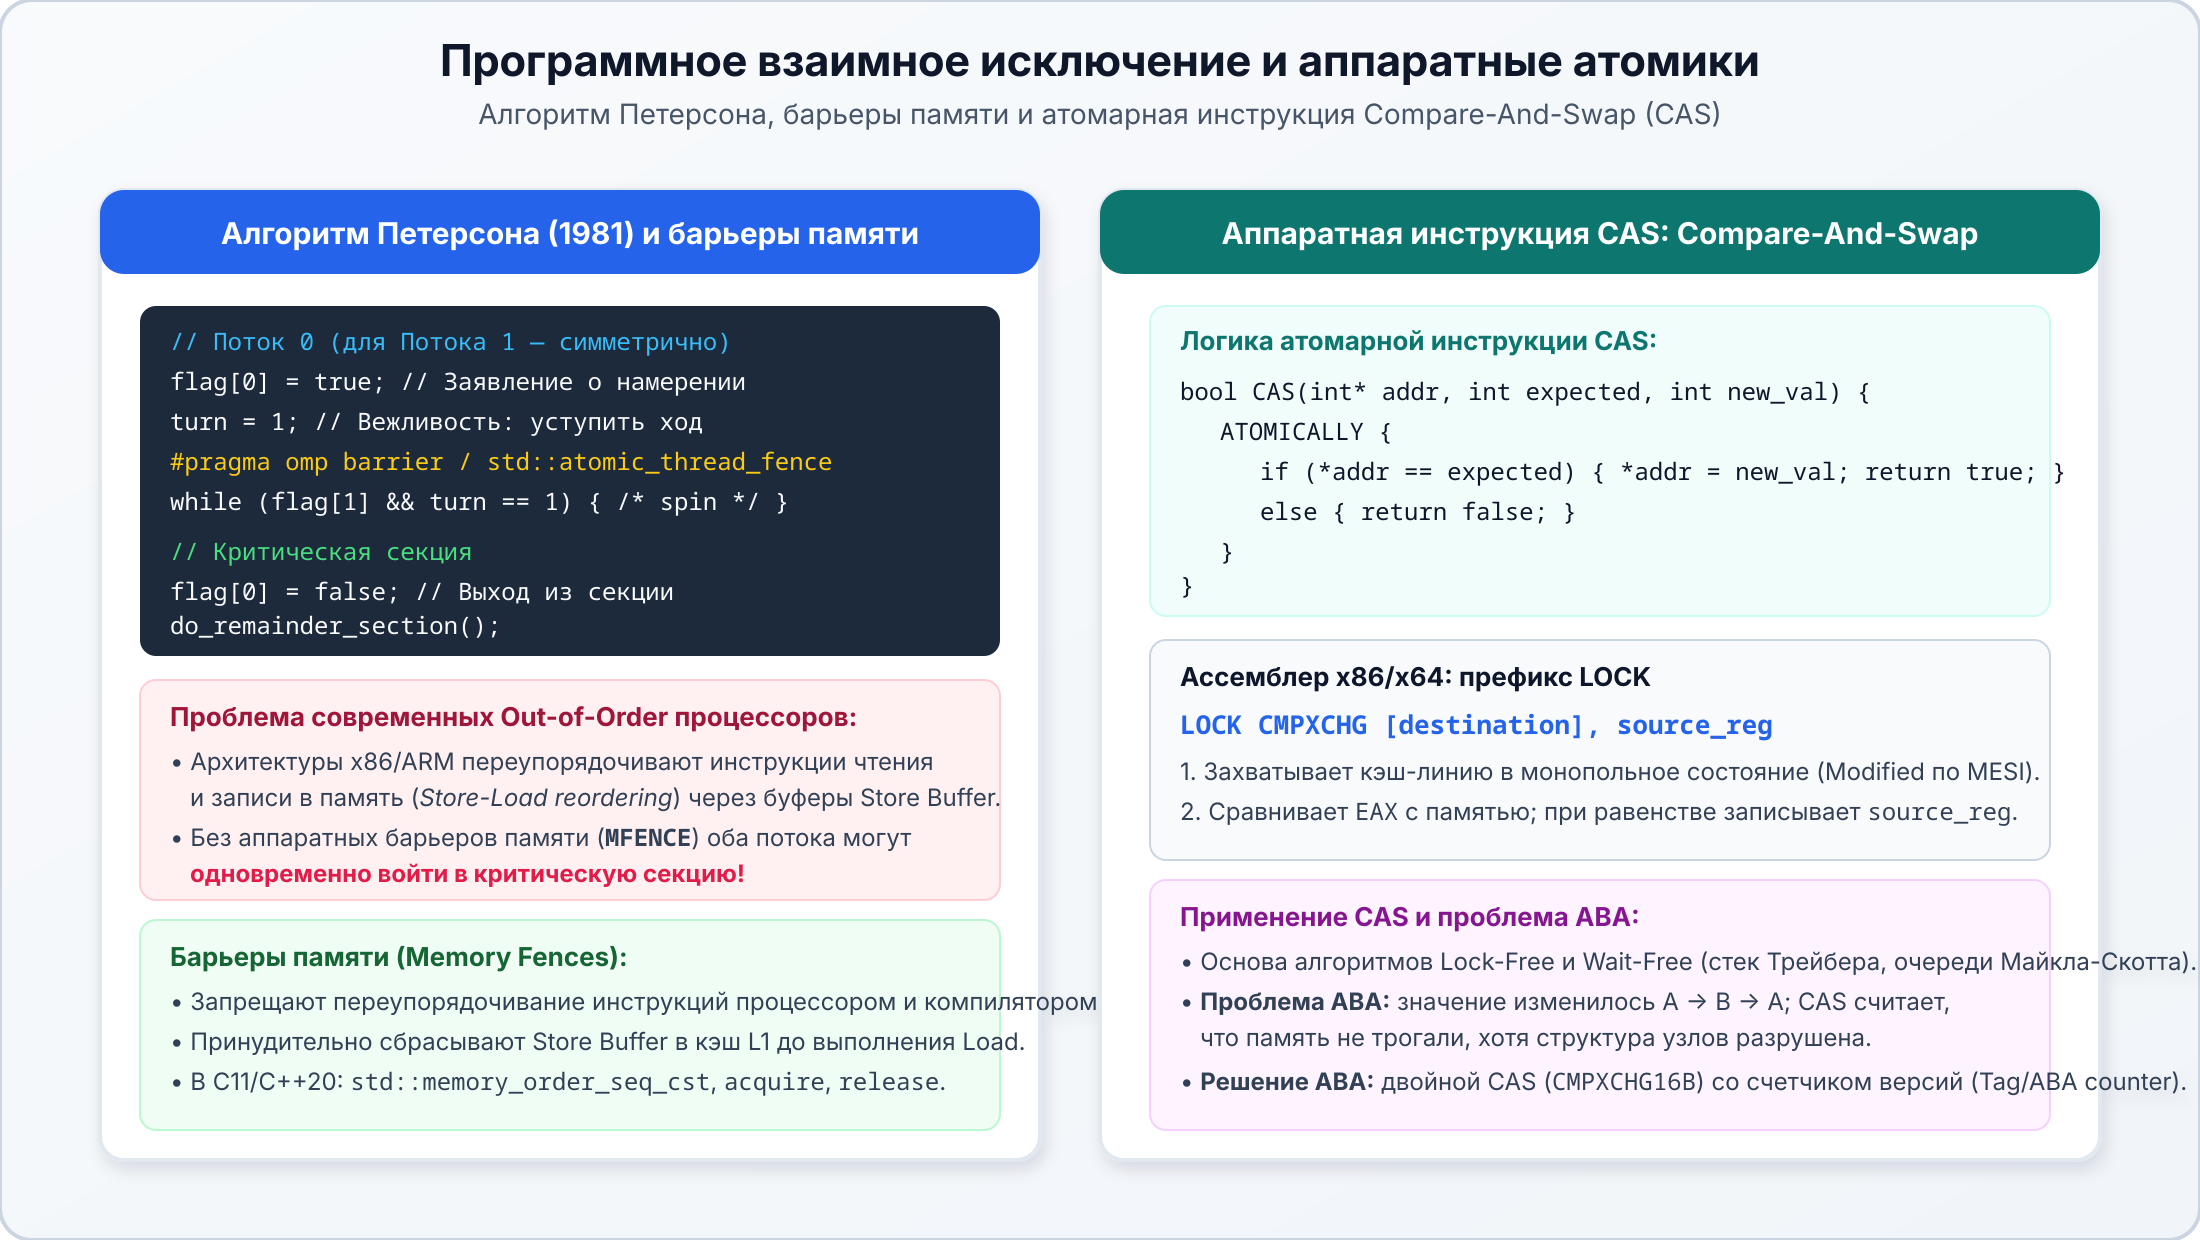
3. Аппаратная поддержка атомарности и инструкция CAS
📌 Слайд 8: Аппаратная атомарность: Compare-And-Swap (CAS) и префикс LOCK
Чтобы освободить программистов от громоздких программных протоколов взаимного исключения, разработчики микропроцессоров внедрили аппаратные примитивы синхронизации, выполняемые процессором неделимо (атомарно).
Фундаментом современного многопоточного программирования является инструкция Compare-And-Swap (CAS) (в архитектуре x86/x64 — CMPXCHG с префиксом LOCK):
1// Семантика аппаратной операции CAS (выполняется аппаратно неделимо):
2bool AtomicCompareAndSwap(int *addr, int expected, int new_val) {
3    // Вся последовательность защищена аппаратной блокировкой кэш-линии
4    if (*addr == expected) {
5        *addr = new_val;
6        return true;  // Обмен успешен
7    }
8    return false;     // Значение изменилось другим потоком, обмен отклонен
9}
Механизм аппаратного исполнения:
- На ранних процессорах префикс
LOCKфизически выставлял высокий сигнал на ножке шины памяти (LOCK#), блокируя доступ к оперативной памяти для всех остальных процессоров. - На всех современных процессорах x86/x64 применяется блокировка кэш-линии (Cache-line Lock) в рамках протокола когерентности MESI (Modified, Exclusive, Shared, Invalid). Ядро переводит строку кэша, содержащую адрес переменной, в состояние Modified, запрещая другим ядрам читать или модифицировать её до завершения операции
CMPXCHG.
В коде на Си в Windows и Linux атомарные операции доступны через стандартные системные интерфейсы:
1// Windows WinAPI
2LONG InterlockedCompareExchange(LONG volatile *Destination, LONG ExChange, LONG Comperand);
3LONG InterlockedIncrement(LONG volatile *Addend);
4
5// GCC / Clang Builtins / C11
6bool __atomic_compare_exchange_n(type *ptr, type *expected, type desired, ...);
📌 Слайд 9: Проблема ABA в Lock-Free структурах и ее решение
Инструкция CAS лежит в основе создания свободных от блокировок алгоритмов и структур данных (Lock-Free Data Structures, например, стек Трейбера, очереди Майкла-Скотта). Однако в неблокирующих структурах данных кроется классическая архитектурная уязвимость — проблема ABA:
- Поток 1 считывает из разделяемого указателя вершину стека со значением
A. Поток 1 планирует выполнитьCAS(&top, A, A->next). - Планировщик прерывает Поток 1.
- Поток 2 извлекает элемент
A, затем элементB, и освобождает память из-подA. - Поток 3 выделяет новый узел, и аллокатор памяти (
malloc) возвращает тот же самый виртуальный адрес, который ранее принадлежал узлуA. Поток 3 помещает узел по адресуAобратно в стек. - Просыпается Поток 1. Он проверяет адрес вершины:
*top == A. Сравнение успешно! ИнструкцияCASзаменяет вершину наA->next(указывавший на уже уничтоженный узелB). - Итог: структура данных фатально разрушена, возникла ошибка Use-After-Free.
Решение проблемы ABA:
- Маркированные указатели / Счетчики поколений (Tagged Pointers): вместе с адресом хранится 64-битный счетчик изменений (Tag). При каждой модификации счетчик инкрементируется:
(A, ver 1) -> (B, ver 2) -> (A, ver 3). Операция CAS проверяет одновременно адрес и счетчик версии. - В 64-битных системах x86-64 для атомарного обновления 128-битной пары
(указатель + счетчик)применяется специальная аппаратная инструкцияLOCK CMPXCHG16B.
4. Иерархия примитивов синхронизации и накладные расходы
📌 Слайд 10: Иерархия и накладные расходы примитивов синхронизации
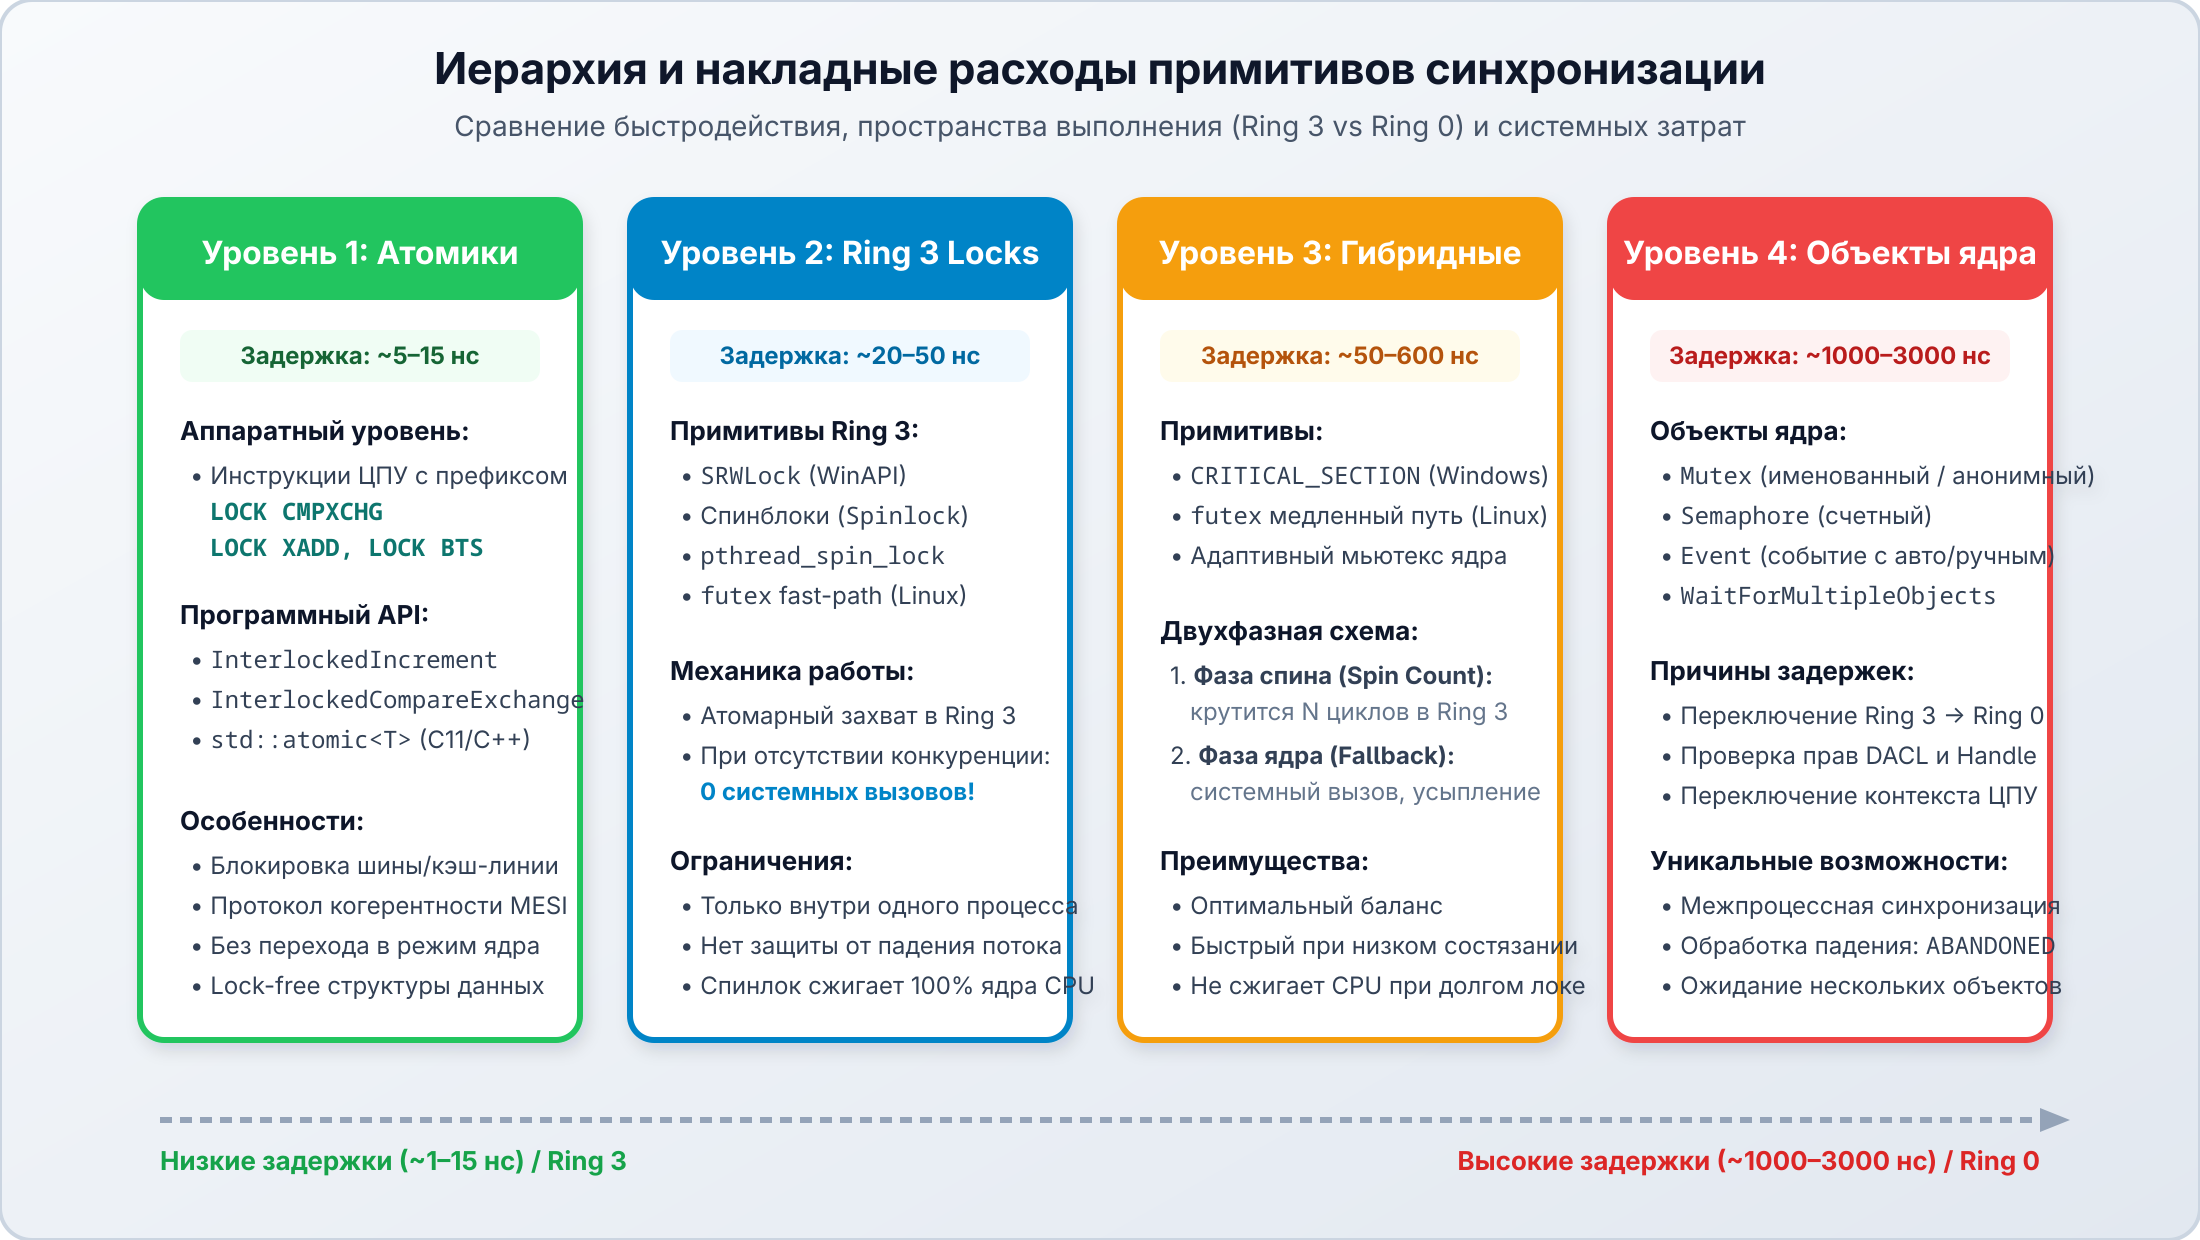
Каждый механизм синхронизации представляет собой компромисс между скоростью захвата ресурса при отсутствии конкуренции и энергоэффективностью при длительном удержании блокировки.
📌 Слайд 11: Примитивы пользовательского режима: Спинлоки и SRWLock
1. Спинлоки (Spinlocks)
Спинлок — это простейшая блокировка на основе атомарного флага:
 1typedef struct {
 2    volatile int lock_state;
 3} spinlock_t;
 4
 5void spin_lock(spinlock_t *sl) {
 6    while (__atomic_test_and_set(&(sl->lock_state), __ATOMIC_ACQUIRE)) {
 7        #if defined(__x86_64__) || defined(_M_X64)
 8        _mm_pause(); // Инструкция PAUSE: снижает энергопотребление и сброс конвейера ЦПУ
 9        #endif
10    }
11}
12
13void spin_unlock(spinlock_t *sl) {
14    __atomic_clear(&(sl->lock_state), __ATOMIC_RELEASE);
15}
- Преимущество: сверхмалая задержка входа (~10–20 нс), отсутствие системных вызовов.
- Опасность: пока блокировка занята, ждущий поток сжигает 100% ядра процессора в пустом цикле, попутно перегревая кристалл и перегружая шину когерентности кэшей. Спинлоки допустимы только в том случае, если критическая секция гарантированно выполняется за доли микросекунды.
2. Блокировка чтения-записи SRWLock (Slim Reader/Writer Lock)
В Windows Vista/7 был представлен ультралегковесный примитив SRWLOCK:
- Занимает ровно размер одного машинного указателя (8 байт на 64-битных ОС).
- Поддерживает разделяемый доступ для читателей (
AcquireSRWLockShared) и монопольный для писателей (AcquireSRWLockExclusive). - При отсутствии состязания вход выполняется за одну атомарную инструкцию без выделения объектов ядра.
📌 Слайд 12: Двухфазные гибридные блокировки: CRITICAL_SECTION и Futex
Для устранения недостатков чистого активного ожидания (spin) и тяжеловесных системных вызовов в современных операционных системах применяются двухфазные гибридные блокировки:
CRITICAL_SECTION в Windows
Структура CRITICAL_SECTION совмещает счетчик спина и резервный объект ядра:
- Фаза спина (Spin Phase): поток пытается захватить блокировку в цикле активного ожидания $N$ раз (по умолчанию в многопроцессорных системах spin count задается функцией
SetCriticalSectionSpinCount(&cs, 4000)). Если владелец успел освободить секцию за это время, поток входит без системного вызова. - Фаза ядра (Sleep Phase): если число попыток исчерпано, поток вызывает системный вызов ядра, который переводит поток в глубокий сон в очереди планировщика до сигнала освобождения.
Механизм futex (Fast Userspace Mutex) в Linux
futex — это системный вызов ядра Linux, ставший стандартом де-факто:
- В пользовательском пространстве блокировка представлена обычным 32-битным целым числом
int. - Захват и освобождение без состязания производятся в Ring 3 с помощью атомарной операции
atomic_cmpxchg(0 системных вызовов!). - Системный вызов
sys_futex(addr, FUTEX_WAIT, val, ...)вызывается ядром только при наличии фактического конфликта, когда необходимо усыпить ожидающий поток.
5. Условные переменные (Condition Variables)
📌 Слайд 13: Условные переменные (Condition Variables)
Часто потоку требуется не просто войти в критическую секцию, а дождаться выполнения некоторого логического условия над разделяемыми данными (например, «очередь задач стала непустой»). Опрашивать условие в бесконечном цикле (busy polling) недопустимо.
Для эффективного решения этой задачи используются условные переменные (Condition Variables):
- В Windows:
CONDITION_VARIABLE, функцииSleepConditionVariableCS/SleepConditionVariableSRW,WakeConditionVariable,WakeAllConditionVariable. - В POSIX / Linux:
pthread_cond_t, функцииpthread_cond_wait,pthread_cond_signal,pthread_cond_broadcast.
Канонический шаблон ожидания предиката:
 1// Всегда проверять условие в цикле while, а не в if!
 2AcquireSRWLockExclusive(&lock);
 3
 4while (!predicate_is_true()) { // Защита от Spurious Wakeups (ложных пробуждений)
 5    // Атомарно освобождает lock и усыпляет поток; при пробуждении повторно захватывает lock
 6    SleepConditionVariableSRW(&cond, &lock, INFINITE, 0);
 7}
 8
 9// Выполнение полезной работы в защищенной критической секции...
10
11ReleaseSRWLockExclusive(&lock);
Важно: феномен ложных пробуждений (Spurious Wakeups). Стандарты POSIX и WinAPI допускают, что функция ожидания условной переменной может вернуть управление без явного вызова сигнала (
WakeConditionVariable). По этой причине условие ожидания всегда оборачивается в циклwhile.
6. Классическая задача: «Производители–Потребители»
📌 Слайд 14: Задача «Производители–Потребители» (Bounded Buffer Problem)
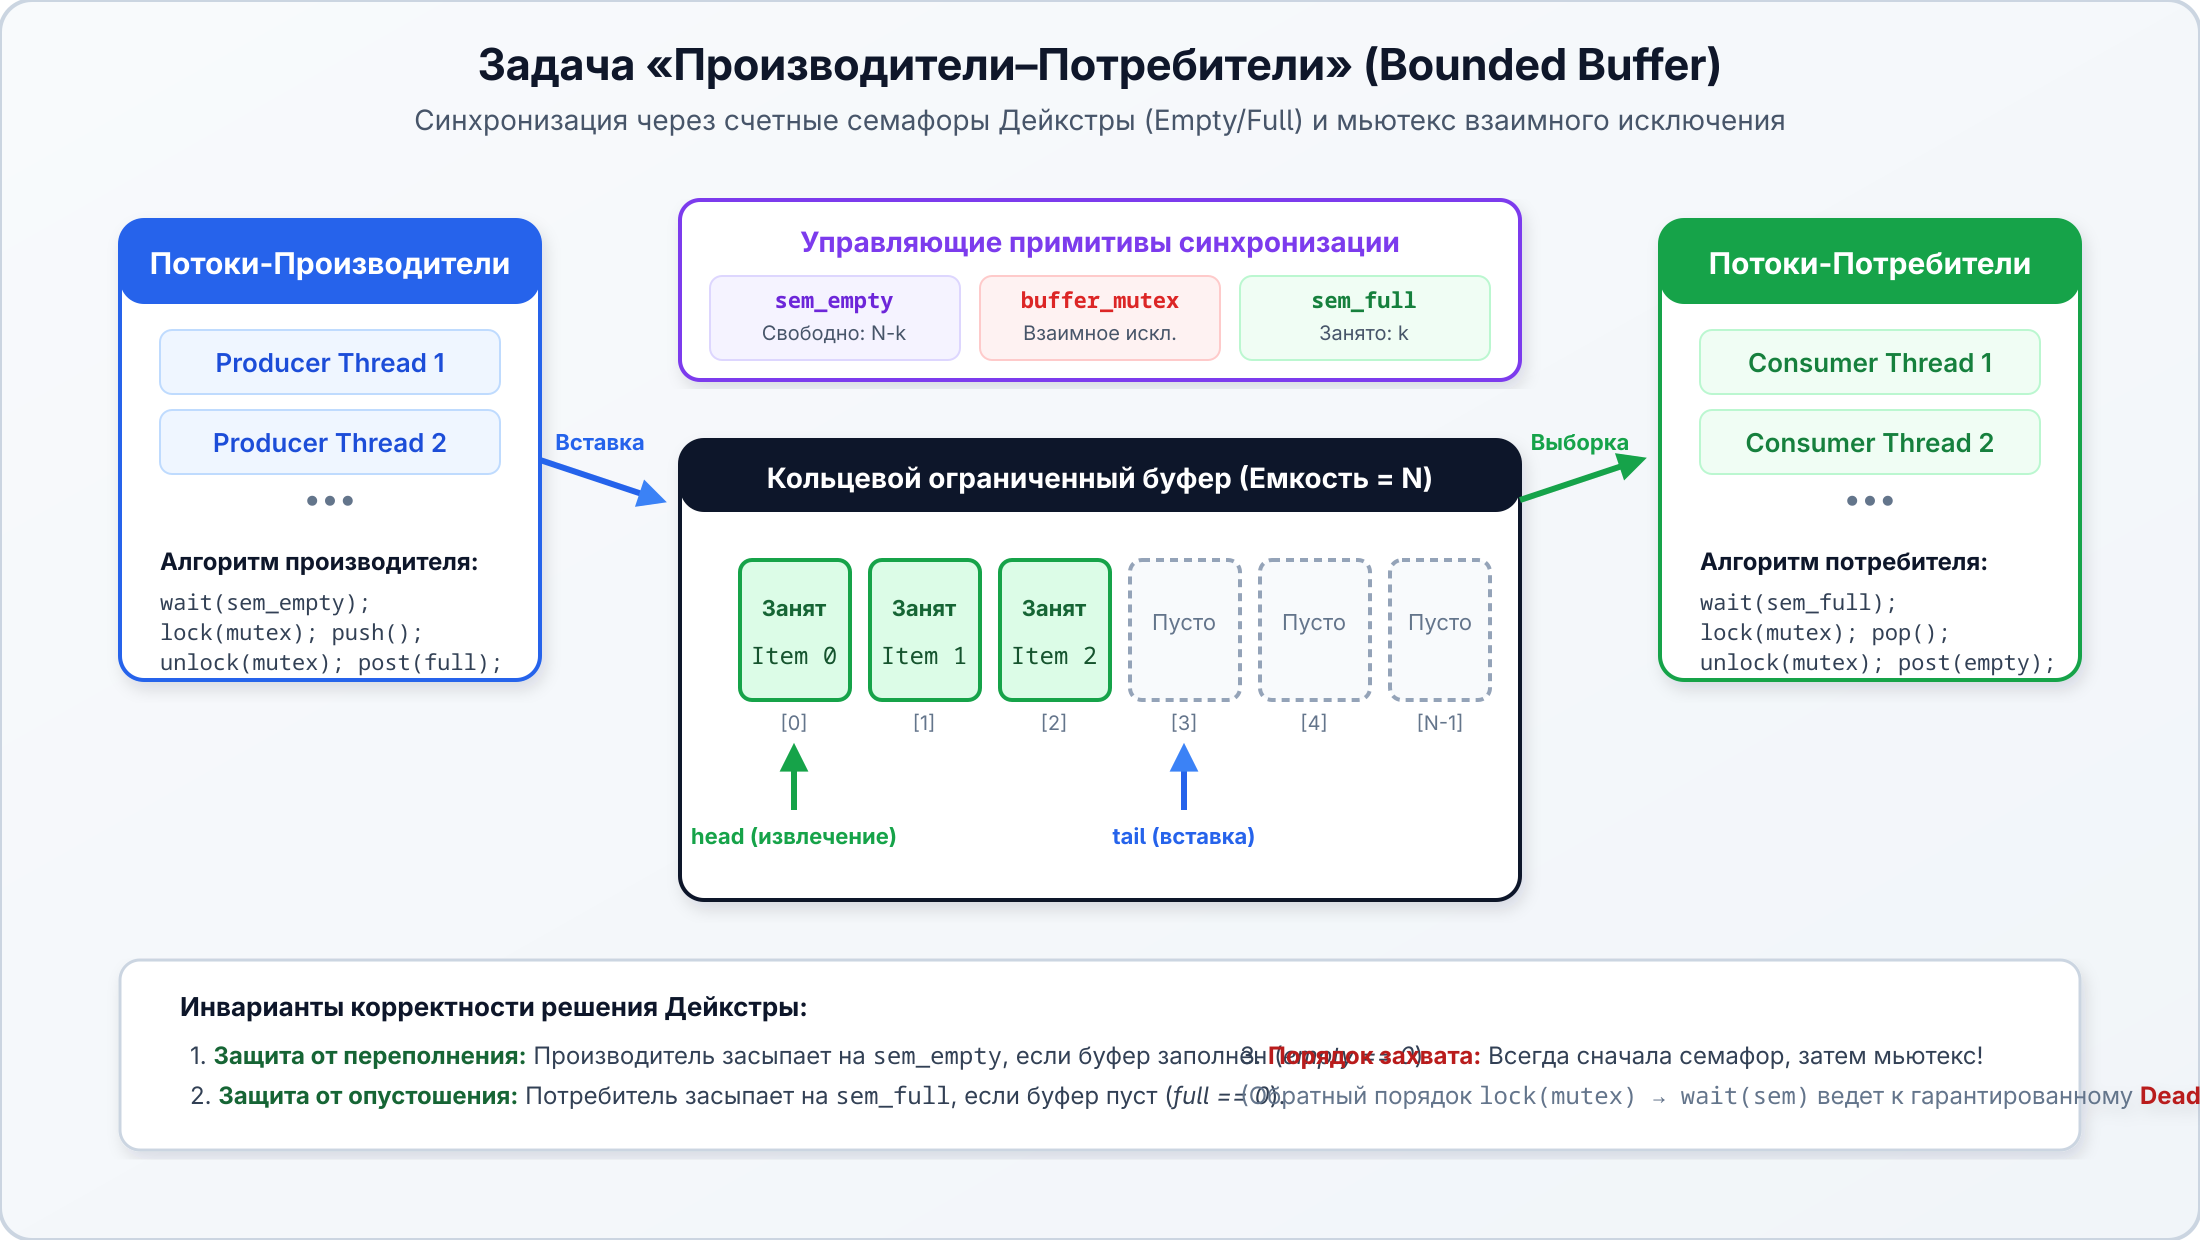
Задача «производители-потребители» — это фундаментальная модель параллельной обработки данных, в которой одна группа потоков непрерывно генерирует элементы данных и помещает их в кольцевой буфер ограниченного размера $N$, а вторая группа потоков извлекает и обрабатывает эти элементы.
📌 Слайд 15: Реализация схемы Производитель–Потребитель на семафорах
Для классического решения Дейкстры требуются три примитива синхронизации:
- Семафор
sem_empty— инициализируется значением $N$ (число свободных слотов в буфере). - Семафор
sem_full— инициализируется значением0(число готовых к выборке элементов). - Мьютекс
buffer_mutex— обеспечивает монопольный доступ к индексам массиваheadиtail.
 1#include <windows.h>
 2#define BUFFER_SIZE 8
 3
 4typedef struct {
 5    int data[BUFFER_SIZE];
 6    int head; // Индекс извлечения
 7    int tail; // Индекс добавления
 8    HANDLE sem_empty;    // Доступно свободных ячеек
 9    HANDLE sem_full;     // Доступно заполненных ячеек
10    CRITICAL_SECTION cs; // Защита указателей буфера
11} bounded_buffer_t;
12
13void Buffer_Init(bounded_buffer_t *b) {
14    b->head = 0;
15    b->tail = 0;
16    b->sem_empty = CreateSemaphoreW(NULL, BUFFER_SIZE, BUFFER_SIZE, NULL);
17    b->sem_full  = CreateSemaphoreW(NULL, 0, BUFFER_SIZE, NULL);
18    InitializeCriticalSection(&b->cs);
19}
20
21// Вызывается потоком-производителем
22void Buffer_Produce(bounded_buffer_t *b, int item) {
23    // 1. Ждем свободного слота (уменьшаем sem_empty)
24    WaitForSingleObject(b->sem_empty, INFINITE);
25
26    // 2. Входим в критическую секцию модификации кольцевого буфера
27    EnterCriticalSection(&b->cs);
28    b->data[b->tail] = item;
29    b->tail = (b->tail + 1) % BUFFER_SIZE;
30    LeaveCriticalSection(&b->cs);
31
32    // 3. Сигнализируем появление нового элемента (+1 к sem_full)
33    ReleaseSemaphore(b->sem_full, 1, NULL);
34}
35
36// Вызывается потоком-потребителем
37int Buffer_Consume(bounded_buffer_t *b) {
38    int item;
39    // 1. Ждем готового элемента (уменьшаем sem_full)
40    WaitForSingleObject(b->sem_full, INFINITE);
41
42    // 2. Входим в критическую секцию выборки
43    EnterCriticalSection(&b->cs);
44    item = b->data[b->head];
45    b->head = (b->head + 1) % BUFFER_SIZE;
46    LeaveCriticalSection(&b->cs);
47
48    // 3. Сигнализируем освобождение ячейки (+1 к sem_empty)
49    ReleaseSemaphore(b->sem_empty, 1, NULL);
50    return item;
51}
Критическое правило порядка захвата: семафор ожидания свободного/заполненного слота должен захватываться строго до входа в критическую секцию мьютекса! Если поменять порядок (
EnterCriticalSection->WaitForSingleObject(sem)), при заполнении или опустошении буфера произойдет гарантированная взаимоблокировка (Deadlock).
7. Взаимоблокировки (Deadlock) и условия Коффмана
📌 Слайд 16: Проблема взаимных блокировок (Deadlock) и 4 условия Коффмана
Взаимоблокировка (Deadlock) — это аварийная ситуация в многопоточной системе, при которой два или более потока бесконечно заблокированы в ожидании освобождения ресурсов, удерживаемых друг другом.
В 1971 году Эдвард Коффман сформулировал четыре необходимых и достаточных условия возникновения дедлока:
- Взаимное исключение (Mutual Exclusion): хотя бы один ресурс неделим и может удерживаться только одним потоком.
- Удержание и ожидание (Hold and Wait): поток удерживает хотя бы один ресурс и одновременно запрашивает новые ресурсы, занятые другими потоками.
- Невытесняемость (No Preemption): ресурс не может быть принудительно отобран у удерживающего его потока; освобождение возможно только добровольно.
- Круговое ожидание (Circular Wait): существует замкнутый цикл потоков и ресурсов, где каждый поток ждет ресурс, занятый следующим потоком в кольце.
📌 Слайд 17: Граф распределения ресурсов и цикл дедлока
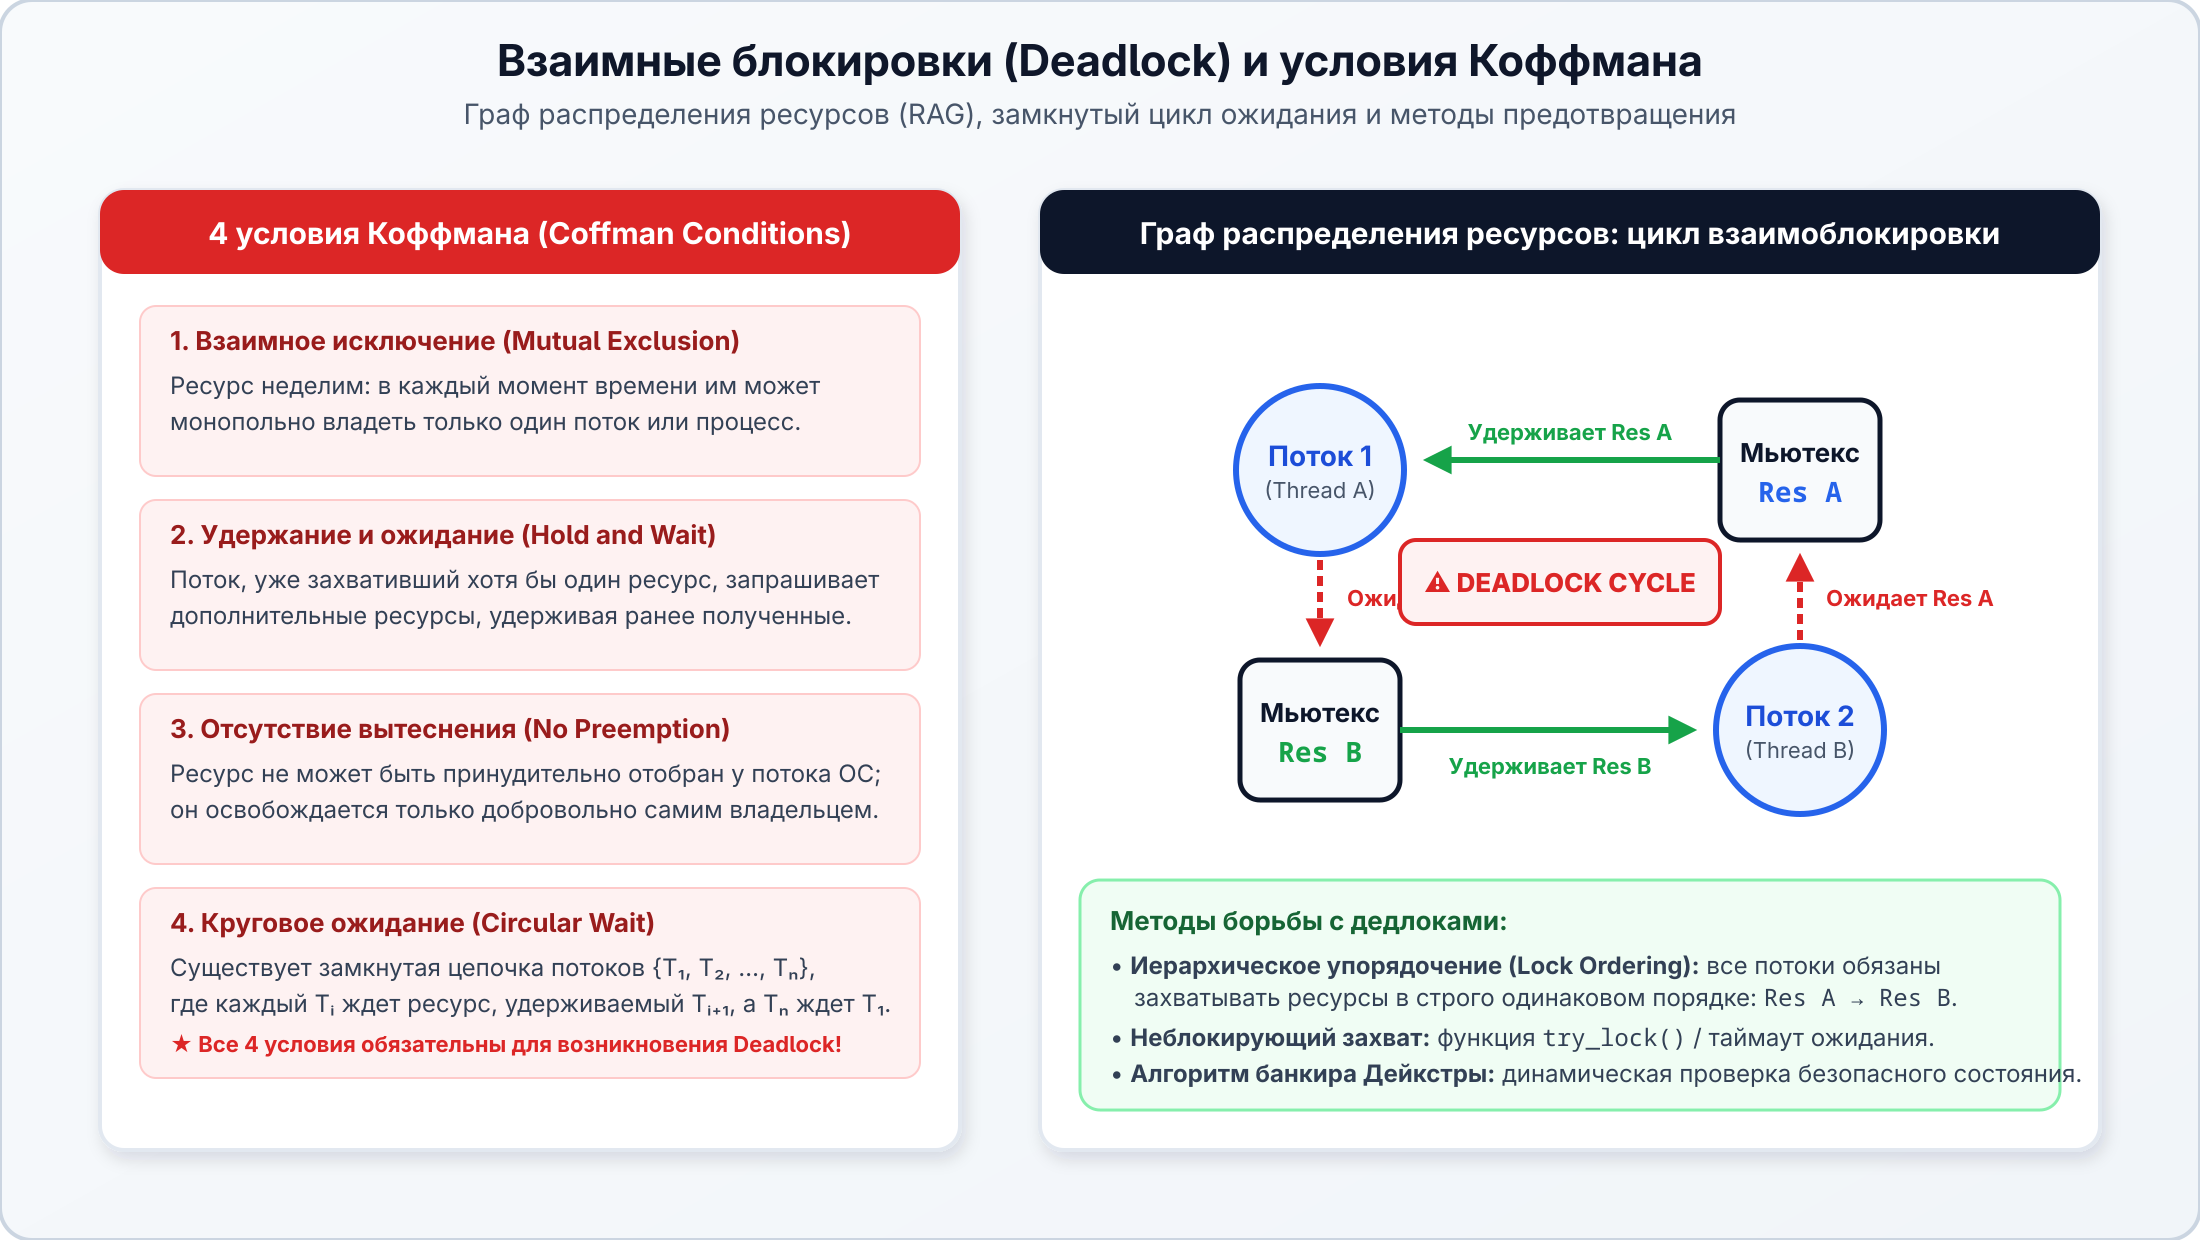
В теории операционных систем состояние системы формализуется ориентированным двудольным графом распределения ресурсов (Resource Allocation Graph, RAG):
- Вершины-потоки $T$ изображаются кругами.
- Вершины-ресурсы $R$ изображаются прямоугольниками.
- Ребро назначения $R \to T$ означает, что ресурс выделен потоку.
- Ребро запроса $T \to R$ означает, что поток заблокирован в ожидании ресурса.
Наличие ориентированного цикла в графе RAG при условии однократного экземпляра каждого ресурса является строгим доказательством наличия взаимной блокировки.
📌 Слайд 18: Стратегии предотвращения и устранения дедлоков
Для борьбы с дедлоками применяются четыре стратегии:
- Иерархическое упорядочение ресурсов (Lock Ordering):
- Самый надежный инженерный метод. Все разделяемые ресурсы системы нумеруются: $R_1, R_2, …, R_n$.
- Любой поток имеет право захватывать ресурсы строго в порядке возрастания их номеров.
- Это математически исключает 4-е условие Коффмана (круговое ожидание), делая возникновение цикла циклической зависимости невозможным.
- Неблокирующий захват с откатом (
try_lock):- Поток пытается захватить ресурс функцией
TryEnterCriticalSectionилиTryAcquireSRWLockExclusive. - Если второй ресурс занят, поток не блокируется, а немедленно освобождает все ранее захваченные ресурсы, делает паузу (backoff) и повторяет попытку с начала.
- Поток пытается захватить ресурс функцией
- Алгоритм банкира Дейкстры (Banker’s Algorithm):
- Динамический алгоритм проверки безопасности выделения ресурсов, используемый в планировщиках ОС. Ресурс выделяется потоку только в том случае, если после этого существует хотя бы одна последовательность завершения всех потоков системы.
- Обнаружение и восстановление (Detection and Recovery):
- Периодическое сканирование графа распределения ресурсов фоновым сторожевым потоком (Watchdog). При обнаружении цикла один из потоков принудительно прерывается с откатом транзакции.
8. Задача об обедающих философах
📌 Слайд 19: Задача об обедающих философах (Dining Philosophers)
Сформулированная Э. Дейкстрой в 1965 году задача об обедающих философах служит классической иллюстрацией конфликта за ресурсы:
- За круглым столом сидят 5 философов, которые проводят время в размышлениях и еде.
- Между каждыми двумя философами лежит одна вилка (всего 5 вилок).
- Чтобы поесть, философу требуются две вилки (левая и правая).
Наивное решение и фатальный дедлок:
Если каждый философ одновременно возьмет левую вилку, а затем попытается взять правую, все 5 философов навсегда заблокируются в ожидании правой вилки, удерживая левую (выполняются все 4 условия Коффмана). Философы погибнут от голода.
Инженерные решения:
- Асимметричное упорядочение (Lock Ordering): четные философы сначала берут левую вилку, затем правую; нечетные — сначала правую, затем левую. Цикл кругового ожидания разрывается.
- Ограничение числа обедающих: за стол с 5 вилками допускаются не более 4 философов одновременно с помощью счетного семафора емкостью 4. Как минимум один философ всегда гарантированно получит обе вилки, поест и освободит ресурсы.
Резюме и выводы
📌 Слайд 20: Резюме лекции
Основные итоги занятия:
- Состояния гонки (Race Condition) возникают при несогласованном доступе параллельных потоков к разделяемой памяти и устраняются изоляцией критических секций.
- Условия Дейкстры (взаимное исключение, прогресс, ограниченное ожидание) определяют фундаментальные критерии корректности любого механизма синхронизации.
- Алгоритм Петерсона решает задачу взаимного исключения программно, но на современных многоядерных процессорах с внеочередным исполнением (Out-of-Order) требует обязательного применения барьеров памяти (
MFENCE). - Аппаратные атомики (CAS,
LOCK CMPXCHG) реализуют неделимое сравнение с заменой на уровне кэш-линий (протокол MESI) и служат базой как для Lock-Free алгоритмов, так и для примитивов пользовательского режима. - Проблема ABA в неблокирующих структурах данных решается версионированием указателей (Tagged Pointers) с помощью 128-битной инструкции
CMPXCHG16B. - Легковесные блокировки (
SRWLock,CRITICAL_SECTION,futex) работают в пространстве пользователя (Ring 3) с минимальными задержками (~10–40 нс), обращаясь к ядру только при возникновении реального состязания. - Схема «Производители-Потребители» эффективно координирует потоки через пару счетных семафоров (
empty,full) и мьютекс критической секции. - Взаимоблокировка (Deadlock) возникает строго при одновременном выполнении 4 условий Коффмана и надежно предотвращается строгим иерархическим упорядочением захвата блокировок (Lock Ordering).
Контрольные вопросы для самопроверки
📌 Слайд 21: Вопросы для самопроверки
- Сформулируйте три фундаментальных критерия Дейкстры для взаимного исключения в критических секциях.
- Почему классический алгоритм Петерсона не обеспечивает взаимного исключения на современных многоядерных процессорах без использования инструкций барьеров памяти?
- В чем заключается логика выполнения процессорной инструкции Compare-And-Swap (CAS) и как обеспечивается её неделимость на уровне шины и кэшей ЦПУ?
- Что такое проблема ABA в неблокирующих структурах данных и каким образом она решается с помощью версионирования указателей?
- В чем заключается различие между спинлоком (
Spinlock) и примитивомSRWLockс точки зрения нагрузки на процессор? - Как устроен двухфазный алгоритм захвата в объекте
CRITICAL_SECTIONв Windows и механизмеfutexв Linux? - Почему при ожидании условной переменной (
CONDITION_VARIABLE/pthread_cond_t) проверка условия обязана выполняться в циклеwhile, а не через условный операторif? - Перечислите четыре условия Коффмана, необходимые и достаточные для возникновения взаимоблокировки (Deadlock).
- Каким образом принцип иерархического упорядочения захвата блокировок (Lock Ordering) предотвращает возникновение взаимных блокировок?
- Как решается проблема дедлока в классической задаче об обедающих философах с использованием асимметричного захвата вилок?
Рекомендуемая литература и источники
📌 Слайд 22: Литература и рекомендуемые ресурсы
Основная литература:
- Современные операционные системы (4-е изд.) — Таненбаум Э., Бос Х. СПб.: Питер, 2021. 1119 с.
- Операционные системы (2-е изд.) — Гордеев А. В. СПб.: Питер, 2009. 415 с.
- Устройство и функционирование OC Windows — Коньков К. А. М.: Бином, 2008. 208 с.
- Системное программирование: методические указания к лабораторным работам — Бизюк А. Н., Соколова А. С. Витебск: УО «ВГТУ», 2024.
Дополнительная литература и первоисточники:
- Уильямс, Э. Параллельное программирование на C++ в действии. Практика разработки многопоточных программ. — М.: ДМК Пресс, 2021. 672 с.
- Руссинович, М., Соломон, Д., Ионеску, А. Внутреннее устройство Microsoft Windows (7-е изд.). — СПб.: Питер, 2018.
- Dijkstra, E. W. Solution of a Problem in Concurrent Programming Control // Communications of the ACM. 1965. Vol. 8, No. 9. P. 569.
- Coffman, E. G., Elphick, M. J., Shoshani, A. System Deadlocks // ACM Computing Surveys. 1971. Vol. 3, No. 2. P. 67–78.
- Microsoft Learn: Synchronization Primitives — https://learn.microsoft.com/en-us/windows/win32/sync/synchronization